
26 KiB
IOT Technologies
Serialisation
Sérialiser est nécessaire pour deux principales raisons :
-
Communication entre systèmes : Lorsque des objets résident en mémoire vive (RAM) et doivent être échangés avec d'autres systèmes via des canaux de communication, la sérialisation les convertit en séquences d'octets pouvant être transmises efficacement.
-
Stockage persistant : Parfois, il est nécessaire de conserver des objets au-delà de l'exécution du programme, les stockant dans une mémoire persistante (comme le stockage de masse). La sérialisation permet de traduire ces objets en un format pouvant être stocké et récupéré ultérieurement.
Basé texte ou binaire
-
Encodage des données :
- Texte : Les données sont encodées sous forme de flux de caractères imprimables (comme dans XML ou JSON).
- Binaire : Les données sont encodées sous forme de flux d'octets, sans nécessiter de représenter les caractères imprimables.
-
Lisibilité et Efficacité :
- Texte : Lisible par les humains, facilite le débogage. Cependant, peut être moins compact, nécessitant plus de bande passante.
- Binaire : Plus compact, nécessite moins de bande passante. Cependant, illisible pour les humains, compliquant le débogage.
Sérialisation basée texte
La sérialisation basée texte est généralement utilisée pour les données structurées, comme les documents XML ou JSON. Ces formats sont lisibles par les humains, ce qui facilite le débogage. Cependant, ils sont moins compacts que les formats binaires, nécessitant plus de bande passante.
XML (eXtensible Markup Language)
XML est un langage de balisage qui définit un ensemble de règles pour l'encodage de documents dans un format qui est à la fois humain et machine lisible. Il est largement utilisé pour représenter des données structurées et pour échanger des informations sur Internet. XML est un format de données ouvert et indépendant du logiciel et du matériel.
-
Structure : XML utilise des balises pour définir des éléments structurés. Chaque élément a une balise d'ouverture et une balise de fermeture. Les balises peuvent contenir des données ou d'autres balises.
-
Attributs : Les éléments peuvent avoir des attributs qui fournissent des informations supplémentaires. Les attributs sont définis à l'intérieur de la balise d'ouverture.
-
Hiérarchie : Les éléments peuvent être imbriqués pour créer une structure hiérarchique, formant ainsi un arbre de données.
-
Document XML : Un document XML commence souvent par une déclaration indiquant la version d'XML utilisée. Ensuite, il a un élément racine qui contient tous les autres éléments du document.
-
Namespace : Les espaces de noms (namespace) permettent d'éviter les conflits de noms en associant un préfixe à un espace de noms unique.
-
Caractères d'échappement : Certains caractères spéciaux (comme
<,>,",',&) doivent être échappés pour éviter toute confusion avec la syntaxe XML. -
Validation : La validité d'un document XML peut être vérifiée en le comparant à un schéma XML (XSD) qui définit la structure attendue du document.
Éléments :
<tag>
  data
</tag>
Attributs :
<tag attribute="metadata">
  data
</tag>
Namespace :
<tag xmlns:f="https://namespace.com/example/">
  <f:subtag>
      data
  </f:subtag>
</tag>
Exemple
<?xml version="1.0" encoding="ASCII"?>
<disco>
<cd style="Classic">
<title>For ever</title>
<artist>Pavarotti</artist>
<songs>
<song appreciation="preferred">
<title>No, la morte</title>
<length>3:50</length>
</song>
<song>
<title>Che voi m 'amate</title>
<length>2:55</length>
</song>
</songs>
<price>30</price>
</cd>
</disco>

En résumé, XML offre une syntaxe flexible pour décrire des données structurées de manière lisible par les humains et interprétable par les machines, facilitant l'échange d'informations entre systèmes hétérogènes.
JSON (JavaScript Object Notation)
JSON est un format de données léger et facile à lire et à écrire. Il est basé sur un sous-ensemble du langage de programmation JavaScript. JSON est un format de données texte qui est complètement indépendant du langage mais utilise des conventions familières aux programmeurs. Ces propriétés font de JSON un langage d'échange de données idéal.
-
Objets et Tableaux : JSON utilise des objets (encadrés par
{}) et des tableaux (encadrés par[]) pour organiser les données. Les objets contiennent des paires clé-valeur, tandis que les tableaux sont des listes ordonnées de valeurs. -
Paires Clé-Valeur : Les données sont représentées par des paires clé-valeur à l'intérieur des objets. Les clés sont des chaînes de caractères, et les valeurs peuvent être des nombres, des chaînes, des booléens, des objets, des tableaux ou null.
-
Imbrication : Les objets et les tableaux peuvent être imbriqués pour créer une structure hiérarchique et représenter des données complexes.
-
Caractères d'Échappement : Certains caractères spéciaux, comme les guillemets doubles (
") et les barres obliques inverses (\), peuvent nécessiter un échappement dans les chaînes de caractères. -
Lecture et Écriture : Les langages de programmation fournissent des fonctions pour convertir des objets ou des chaînes JSON en structures de données utilisables et vice versa.
-
Interopérabilité : JSON est largement utilisé pour l'échange de données entre serveurs et clients, car il est facilement compréhensible et traitable dans de nombreux langages de programmation.
Exemple
{
  "disco": [
    {
      "cd": {
      "style": "Classic",
      "title": "For ever",
      "artist": "Pavarotti",
      "songs": [
        {
          "song": {
            "appreciation": "preferred",
            "title": "No, la morte",
            "length": "3:50"
          }
        },
        {
          "song": {
            "title": "Che voi m'amate",
            "length": "2:55"
          }
        }
      ],
      "price": 30
      }
    }
  ]
}
Syntaxe

En résumé, JSON offre une syntaxe simple et lisible pour représenter des données structurées, favorisant l'interopérabilité entre différentes plates-formes et langages.
Sérialisation Binaire
Les Protocol Buffers, ou Protobuf, sont une méthode de sérialisation binaire développée par Google. Voici une explication simple :
-
Sérialisation Binaire : Protobuf permet de convertir des données structurées, comme des objets, en une séquence binaire. Cela facilite la transmission ou le stockage de ces données.
-
Schéma : Les données sérialisées sont définies par un schéma, qui agit comme un contrat décrivant la structure des données. Ce schéma est écrit dans un langage dédié.
-
Compacité et Efficacité : Les données sérialisées avec Protobuf sont plus compactes que d'autres formats textuels comme JSON. Cela les rend plus efficaces à transmettre sur un réseau ou à stocker.
-
Interopérabilité : Protobuf prend en charge la génération automatique de code dans plusieurs langages de programmation, facilitant l'interopérabilité entre différentes plates-formes.
-
Évolution : Le schéma peut évoluer avec le temps sans casser la compatibilité en ajoutant de nouveaux champs. Cela rend Protobuf flexible pour les applications en constante évolution.
En résumé, Protobuf est une façon efficace et flexible de sérialiser des données structurées en binaire, offrant compacité, interopérabilité et facilité d'évolution.
HTTP & REST web services
Les ressources web sont des éléments identifiés par des URL accessibles via le protocole HTTP. Elles peuvent inclure des documents, des services, ou des programmes. Initialement, ces ressources étaient souvent des fichiers statiques sur un serveur HTTP. Les ressources web sont destinées à afficher des informations aux humains, généralement sous la forme de pages HTML, et peuvent également permettre aux utilisateurs d'entrer des informations, par exemple via des formulaires HTML. Une ressource web a un identifiant unique appelé URI (Uniform Resource Identifier), qui peut être dereferenceable, permettant l'accès à la ressource
IRIs, URIs and URLs
Les URL (Uniform Resource Locator) sont un sous-ensemble des URI (Uniform Resource Identifier). Les URL sont des URI qui identifient une ressource par son emplacement sur un réseau. Les URL sont les plus courantes, mais les URI peuvent également identifier des ressources par d'autres moyens, comme le nom ou l'adresse de courrier électronique d'une personne.
-
URI (Uniform Resource Identifier):
- Un URI est une chaîne de caractères utilisée pour identifier de manière unique une ressource.
- Les URI comprennent les URL, les URN, et peuvent être étendus par les IRIs.
http://www.example.com/index.html#date -
URL (Uniform Resource Locator):
- Une URL est un type d'URI qui fournit l'adresse spécifique d'une ressource sur le web.
- Elle inclut le schéma (comme http), le nom du domaine et souvent le chemin d'accès à la ressource.
http://www.example.com/index.html -
URN (Uniform Resource Name):
- Un URN est un sous-type d'URI qui identifie de manière unique une ressource indépendamment de sa localisation.
- Contrairement aux URL, les URN ne fournissent pas d'adresse spécifique pour accéder à la ressource.
//www.example.com/index.html#date -
IRI (Internationalized Resource Identifier):
- Un IRI est une extension d'URI qui peut contenir des caractères non ASCII.
- Il représente de manière unique une ressource sur le web.
http://www.example.com/😉
En résumé, les URIs englobent les URL et les URNs, les URNs identifient de manière unique une ressource sans spécifier son emplacement, et les URLs fournissent une adresse spécifique pour accéder à une ressource sur le web.
HTTP (Hypertext Transfer Protocol)
HTTP est un protocole client-serveur qui permet la communication sur le World Wide Web. Il est sans état, basé sur des requêtes et des réponses, et utilise des codes de statut pour indiquer le résultat d'une requête (par exemple, 200 OK pour succès, 404 Not Found pour ressource non trouvée).
-
Format des URL: Les Uniform Resource Locators (URLs) suivent un format générique :
http://<hôte>:<port>/<chemin>?<query>.Ils comprennent des éléments tels que le nom du serveur, le port, le chemin local sur le serveur, et éventuellement des paramètres de requête.Field Description host DNS name of the server hosting the resource port HTTP server port number
(default for http: 80; default for https: 443)path Local path on HTTP server query Supplementary information to clarify the resource (GET)
or to create / update the resource (PUT / POST) -
Format des requêtes et réponses HTTP: Les requêtes et réponses HTTP sont textuelles et structurées. Les en-têtes contiennent des paires clé-valeur, définissant divers aspects de la communication. Les requêtes peuvent également avoir un corps de message, souvent utilisé pour envoyer des données au serveur.
-
Représentation des ressources & HTTP: Les ressources peuvent avoir différentes représentations, telles que HTML, JSON, ou images. Les clients spécifient les formats acceptables via l'en-tête "Accept", tandis que les serveurs déclarent le format de la réponse avec "Content-Type".

| Satus codes | Description |
|---|---|
| 1xx | Informational |
| 2xx | Success |
| 3xx | Redirection to a further URL |
| 4xx | Client Error |
| 5xx | Server Error |
Méthodes de notification serveur

Long polling
Le long polling, ou long polling HTTP, est une technique de communication asynchrone utilisée dans le développement web pour permettre au serveur d'envoyer des mises à jour au client de manière proactive. Contrairement à la méthode traditionnelle où le client interroge régulièrement le serveur pour obtenir des mises à jour (polling), le long polling maintient la connexion ouverte jusqu'à ce que de nouvelles informations soient disponibles.
Voici un aperçu de la méthode du long polling :
-
Requête Bloquante :
- Le client envoie une requête au serveur comme dans une requête normale, mais avec un détail crucial : la connexion reste ouverte pendant un certain temps.
-
Attente de Mises à Jour :
- Le serveur retient la requête jusqu'à ce qu'il ait des informations à transmettre. Pendant ce temps, la connexion reste ouverte.
-
Réponse du Serveur :
- Lorsque de nouvelles données sont disponibles ou qu'un événement survient, le serveur répond à la requête avec les mises à jour.
-
Traitement Côté Client :
- Côté client, le gestionnaire d'événements traite la réponse du serveur et déclenche les actions nécessaires.
-
Nouvelle Requête :
- Après avoir traité la réponse, le client émet une nouvelle requête pour maintenir la connexion ouverte et recevoir d'autres mises à jour.
Le long polling permet aux applications web d'atteindre une communication quasi en temps réel tout en évitant le besoin constant de requêtes fréquentes. Cette technique a été utilisée avant l'avènement de technologies plus modernes comme les WebSockets et Server-Sent Events (SSE).
Cependant, il convient de noter que le long polling peut entraîner des latences et une utilisation intensive des ressources du serveur, car il peut nécessiter la gestion simultanée de nombreuses connexions ouvertes. Les WebSockets et SSE sont souvent préférés pour des performances optimales dans des scénarios de communication en temps réel.
Server-Side Events (SSE)
Les Server-Sent Events (SSE), ou événements envoyés par le serveur, sont une technologie du côté serveur utilisée dans le développement web pour permettre à un serveur d'envoyer des mises à jour unidirectionnelles au client sur une connexion HTTP. SSE fournit une manière simple et efficace pour les serveurs d'envoyer des informations en temps réel aux navigateurs sans que ces derniers aient besoin de constamment interroger le serveur.
Voici comment fonctionnent les Server-Side Events :
-
Établissement de la Connexion :
- Le client crée une connexion HTTP standard vers le serveur.
-
Format des Données :
- Le serveur envoie les données au client sous la forme d'événements. Chaque événement est un message texte qui suit un format spécifique défini par le standard SSE.
-
Flux Continu :
- Une fois la connexion établie, le serveur peut envoyer périodiquement des événements au client sans que ce dernier ait besoin de faire de nouvelles requêtes.
-
Réception Côté Client :
- Côté client, l'événement est intercepté par un gestionnaire d'événements, permettant aux développeurs de réagir aux mises à jour en temps réel.
-
Réintégration Automatique :
- SSE prend également en charge la réintégration automatique de la connexion en cas de déconnexion, ce qui garantit une expérience continue même en cas de problèmes de réseau temporaires.
Avantages :
- Facilité d'utilisation : La mise en œuvre de SSE est relativement simple du côté du serveur et du côté client.
- Faible surcharge réseau : SSE minimise la surcharge réseau en maintenant une connexion ouverte, évitant la nécessité de requêtes fréquentes.
Limitations :
- Unidirectionnel : SSE ne prend en charge que la communication du serveur vers le client. Si le client doit envoyer des données au serveur, une autre méthode, comme AJAX, serait nécessaire.
- Support du Navigateur : Bien que largement pris en charge, SSE peut ne pas être pris en charge par certains navigateurs plus anciens.
En résumé, Server-Sent Events est une technologie qui permet au serveur d'envoyer des mises à jour en temps réel au client sur une connexion HTTP persistante, offrant ainsi une solution efficace pour les applications nécessitant une communication bidirectionnelle asynchrone.
WebSockets
Les WebSockets sont une technologie de communication bidirectionnelle en temps réel entre un navigateur web et un serveur. Contrairement aux approches traditionnelles comme le polling (interrogation régulière du serveur) ou le long polling (maintien d'une connexion ouverte jusqu'à l'arrivée de nouvelles données), les WebSockets établissent une connexion persistante qui permet un échange de données en temps réel entre le client et le serveur.
Voici une brève explication du fonctionnement des WebSockets :
-
Établissement de la Connexion :
- Le processus commence par une poignée de main (handshake) entre le client et le serveur, établissant une connexion WebSocket via une requête HTTP mise à niveau.
-
Communication Bidirectionnelle :
- Une fois la connexion établie, les deux parties (client et serveur) peuvent envoyer des données l'une à l'autre à tout moment, sans avoir besoin d'attendre des requêtes ou des réponses spécifiques.
-
Basse Latence :
- Les WebSockets offrent une latence réduite par rapport aux techniques de polling ou de long polling, car il n'y a pas de délai d'attente entre les demandes et les réponses.
-
Protocole Simple :
- Le protocole WebSocket est relativement simple et léger, facilitant la mise en œuvre et la gestion côté serveur.
-
Applications en Temps Réel :
- Les WebSockets sont largement utilisés dans les applications en temps réel telles que les salons de discussion, les jeux en ligne, les mises à jour en direct, etc.
-
Réintégration Automatique :
- Les WebSockets peuvent gérer automatiquement la réintégration en cas de déconnexion temporaire, assurant une expérience utilisateur continue.
-
Formats de Données :
- Les données échangées via les WebSockets peuvent être au format binaire ou texte, offrant une flexibilité pour différents types d'applications.
-
Fermeture de la Connexion :
- La connexion WebSocket peut être fermée explicitement par le client ou le serveur, ou automatiquement en cas de problème de réseau.
En résumé, les WebSockets sont une technologie de communication en temps réel qui établit une connexion persistante entre le client et le serveur, permettant un échange bidirectionnel de données avec une faible latence, ce qui en fait un choix privilégié pour les applications nécessitant des mises à jour instantanées.
REST (Representational State Transfer)
REST (Representational State Transfer) est un style architectural utilisé dans le développement des services web, basé sur des principes fondamentaux qui favorisent la simplicité, l'évolutivité, et l'interopérabilité. Voici un résumé des principaux concepts de REST :
-
Ressources :
- Tout est une ressource, identifiable par une URI (Uniform Resource Identifier).
- Les ressources représentent des entités ou des concepts du système, comme des données ou des services.
-
Opérations sur les Ressources :
- Les opérations standard (CRUD) sont appliquées aux ressources :
- GET : Récupérer une représentation de la ressource.
- POST : Créer une nouvelle ressource.
- PUT : Mettre à jour une ressource existante.
- DELETE : Supprimer une ressource.
Method Meaning OO notation GET Fetch a representation for a resource {resource}.GET(parameters) POST Modify the resource {resource}.POST(resource
update)PUT Create a resource (the resource URI in the
method call refers to a non-existing resource, to
be created){resource}.PUT(new resource) DELETE Delete a resource {resource}.DELETE()
- Les opérations standard (CRUD) sont appliquées aux ressources :
-
Représentation :
- Les ressources peuvent avoir différentes représentations (XML, JSON, HTML, etc.).
- La représentation est ce qui est envoyé ou reçu lors des opérations sur les ressources.
-
Stateless (Sans État) :
- Chaque requête du client au serveur doit contenir toutes les informations nécessaires à la compréhension et au traitement de la requête.
- Le serveur ne garde pas de trace de l'état du client entre les requêtes.
-
Interaction Client-Serveur :
- La séparation des préoccupations entre client et serveur permet une évolutivité et une maintenabilité accrues.
- Le client et le serveur peuvent évoluer indépendamment tant qu'ils respectent le contrat défini par l'interface REST.
-
Interface Uniforme :
- Une interface uniforme simplifie et standardise les interactions entre le client et le serveur.
- Elle comprend des contraintes telles que l'identification des ressources par des URIs, la manipulation des ressources via la représentation, l'auto-descriptivité des messages, etc.
-
Évolutivité :
- REST favorise l'évolutivité en permettant l'ajout de nouvelles ressources ou fonctionnalités sans perturber les clients existants.
- Les clients accèdent aux ressources via des URIs sans avoir besoin de connaître la structure interne du serveur.
-
État de l'Application (State of the Application) :
- L'état de l'application est représenté et manipulé par les ressources, plutôt que d'être stocké du côté du serveur.
En résumé, REST est un style architectural qui propose une approche simple et standardisée pour la conception de services web, en mettant l'accent sur l'utilisation efficace des ressources, la séparation des préoccupations, la simplicité de l'interface et l'évolutivité.
CoAP (Constrained Application Protocol)
CoAP (Constrained Application Protocol) est un protocole de communication spécialisé pour les appareils à faible puissance et à faible bande passante, comme les capteurs, les actionneurs et les microcontrôleurs. Il est conçu pour être simple et léger, avec un faible encombrement mémoire et une faible utilisation de la bande passante. CoAP est basé sur le protocole UDP et utilise le format de message binaire de HTTP.


MQTT
MQTT (Message Queuing Telemetry Transport) est un protocol de transport de messages léger et ouvert, conçu pour les environnements contraints comme l'Internet des Objets (IoT). Il est basé sur un modèle de publication/abonnement (pub/sub) où les éditeurs envoient des messages à des sujets, et les abonnés reçoivent les messages en fonction de leurs intérêts. MQTT est conçu pour être simple, ouvert, facile à mettre en œuvre et facile à étendre.
MQTT est un protocol binaire. La version courante est MQTT 3.1.1. qui est basé sur TCP/IPv4. MQTT 5.0 est en cours de développement et est basé sur TCP/IPv6.
Caractéristiques
-
Modèle Éditeur-Abonné : Utilise un modèle de publication/abonnement où les éditeurs envoient des messages à des sujets, et les abonnés reçoivent les messages en fonction de leurs intérêts.
-
Hiérarchie de Sujets : Les sujets MQTT organisent les messages de manière hiérarchique, permettant un acheminement efficace des messages aux abonnés pertinents.
- Les sujets sont des chaînes de caractères délimitées par des barres obliques (
/). - Les caractères génériques (
+et (#ou*)) peuvent être utilisés pour les abonnements aux sujets. - Les caractères génériques peuvent être utilisés pour les abonnements aux sujets.
- Les sujets sont des chaînes de caractères délimitées par des barres obliques (
-
Caractéristiques Légères : Faible bande passante, faibles exigences en mémoire (RAM) et faible latence, adapté aux dispositifs embarqués avec des ressources limitées.
-
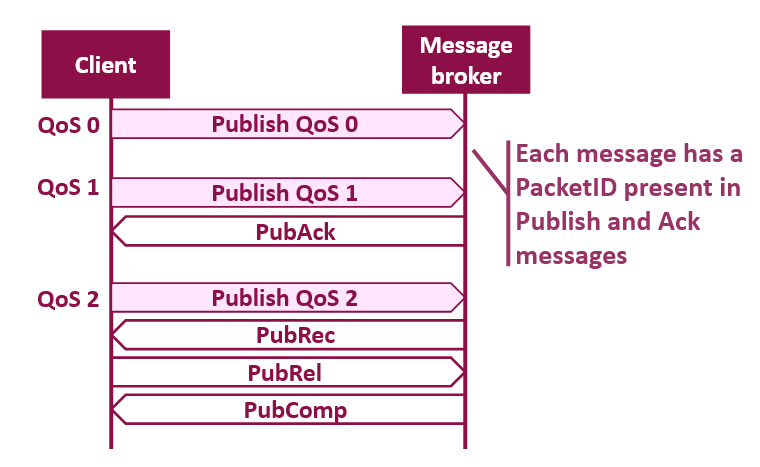
Niveaux de Qualité de Service (QoS) : Propose trois niveaux de QoS, permettant de gérer la fiabilité de la livraison des messages en fonction des besoins de l'application.
- QoS 0 : "At most once" (au plus une fois) : Le message est envoyé une seule fois, sans garantie de livraison.
- QoS 1 : "At least once" (au moins une fois) : Le message est envoyé au moins une fois, garantissant la livraison, mais permettant les doublons.
- QoS 2 : "Exactly once" (exactement une fois) : Le message est envoyé exactement une fois, garantissant la livraison,
sans doublons.
-
Sessions Persistantes : Les sessions persistantes conservent les abonnements et les files d'attente même après la déconnexion, assurant la continuité du traitement des messages.
-
Interopérabilité : MQTT est compatible avec divers protocoles de messagerie. Il peut être utilisé avec RabbitMQ, par exemple, pour assurer l'interopérabilité entre différentes technologies de messagerie (AMQP, STOMP).

Fonctionnalités MQTT
-
Retained Messages : Les messages MQTT peuvent être conservés par le broker et envoyés aux nouveaux abonnés. Cela permet aux abonnés de recevoir les dernières informations sans avoir besoin d'attendre la prochaine mise à jour.
-
Keep Alive : Les clients peuvent envoyer des messages de ping au broker pour maintenir la connexion active. Cela permet de détecter les connexions perdues et de les rétablir.
-
Last Will and Testament (LWT) : Les clients peuvent définir un message LWT qui sera publié par le broker si le client se déconnecte de manière inattendue. Cela permet aux clients de signaler leur état aux autres clients.
-
Sécurité : MQTT prend en charge le chiffrement TLS pour sécuriser les communications. Il prend également en charge l'authentification par nom d'utilisateur et mot de passe.